
Temps de lecture estimé : 5 min · Publié le
Choisir le parcours à protéger
Décrivez l’action essentielle, sa population et les dépendances qui peuvent l’interrompre. Pour une vitrine, il peut s’agir de lire une offre puis envoyer une demande. Pour une boutique, le résultat utile est une commande correctement enregistrée. Séparez le chargement de la page, la réussite de l’action et son traitement ultérieur : ces étapes peuvent connaître des problèmes différents.
Le SRE Workbook de Google expose une méthode d’objectifs de service fondée sur des indicateurs et un accord entre les parties. Adaptez cette démarche à la taille du site. Une équipe réduite peut commencer avec un parcours, un indicateur observable et un responsable plutôt qu’une collection de tableaux sans décision associée.
Définir les événements et leur fenêtre
Écrivez ce qui compte comme tentative et réussite, où l’information est observée et quelles exclusions sont justifiées. Une erreur de validation provoquée par une saisie volontairement invalide ne décrit pas la même chose qu’une perte de demande valide. Une surveillance synthétique et les données d’usage observent des populations différentes ; gardez leurs résultats distincts.
Fixez la fenêtre de lecture et le minimum d’information nécessaire. Sur un site à faible trafic, quelques événements rendent les pourcentages instables. Affichez nombres de tentatives et d’échecs à côté du taux, puis cherchez les cas reproductibles. Ne rassemblez pas inutilement de messages ou de données personnelles pour mesurer un résultat technique.
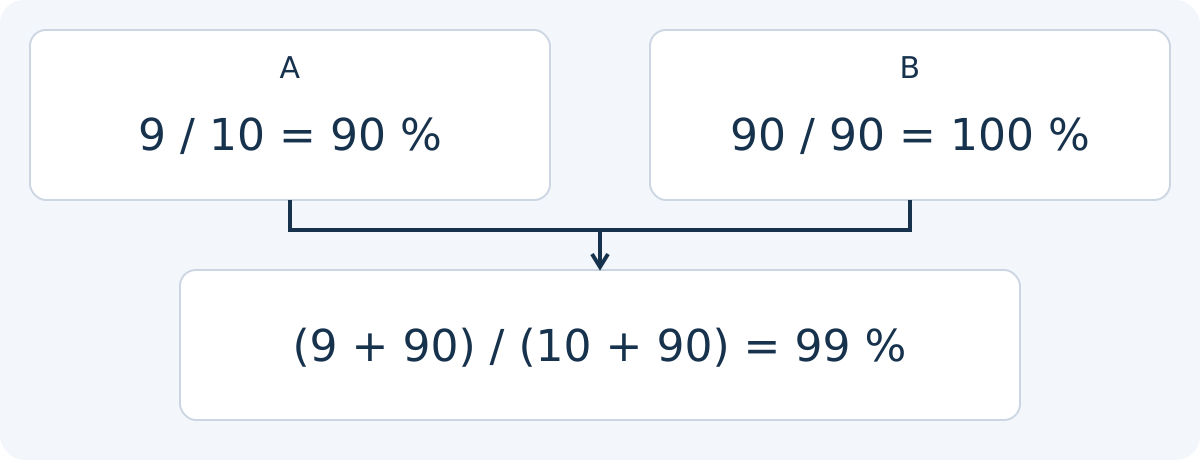
Pour agréger un indicateur par événements, conservez ses effectifs. Exemple fictif : le groupe A compte 9 réussites sur 10 tentatives, soit 90 % ; le groupe B 90 sur 90, soit 100 %. Si les groupes sont disjoints, couvrent la même période et utilisent la même définition de réussite, le total vaut (9 + 90) / (10 + 90) = 99 %. La moyenne simple (90 + 100) / 2 = 95 % décrit une moyenne des taux de groupe, pas le taux de réussite de ces 100 tentatives.
Le SRE Workbook présente les indicateurs sous forme d’événements satisfaisants divisés par l’ensemble des événements retenus. Avant de les additionner, contrôlez dédoublonnage, fenêtre, exclusions et définition de la tentative : une relance peut être un événement supplémentaire sans être une nouvelle demande du visiteur. Gardez les taux par groupe lorsque le total masque un obstacle local. Sans tentative observée, le taux est indéterminé ; une interruption de collecte reste une limite de couverture, pas la preuve de zéro échec. Ces ratios ne mesurent pas automatiquement une disponibilité en temps.
Faites défiler le tableau horizontalement pour lire toutes les colonnes. Au clavier, placez le focus sur le tableau puis utilisez les flèches.
| Population ou calcul | Réussites / tentatives | Interprétation |
|---|---|---|
| Groupe A | 9 / 10 | 90 % |
| Groupe B | 90 / 90 | 100 % |
| Total des tentatives | 99 / 100 | 99 % |
| Moyenne simple des deux taux | (90 + 100) / 2 = 95 % | Même poids donné à chaque groupe, pas à chaque tentative |
Choisir un objectif avant un engagement
Un objectif interne décrit le niveau souhaité et guide une décision. Un engagement contractuel comporte un périmètre et des conséquences qui demandent un accord distinct. Évitez d’adopter un pourcentage élevé parce qu’il semble rassurant. Comparez besoins des visiteurs, contraintes d’exploitation et coût de récupération.
À titre de calcul fictif, 10 échecs sur 1 000 tentatives donnent 99 % de réussites. Cela ne précise ni leur durée, ni les personnes affectées, ni la gravité : les mêmes nombres peuvent couvrir une gêne mineure ou une perte de commandes. Une disponibilité mesurée en temps doit utiliser une autre définition ; ne convertissez pas ces indicateurs l’un dans l’autre sans préciser la méthode.
Relier les seuils à des actions
Décidez qui vérifie une alerte, quelle preuve permet de qualifier l’incident et quel canal informe les personnes concernées. Une panne confirmée peut nécessiter un contournement ou un retour à une version précédente. Une alerte isolée peut demander une vérification avant mobilisation. L’objectif est de réduire l’incertitude et le temps de réponse, pas d’envoyer un message pour chaque variation.
Documentez le cas où la qualité baisse pendant un changement. Le chapitre sur la politique de budget d’erreur présente le principe d’une réponse convenue aux écarts de fiabilité. Pour un petit site, vous pouvez simplement prévoir de différer une évolution facultative jusqu’à résolution d’un défaut critique, sans prétendre appliquer le même dispositif qu’un grand service.
Vérifier les observateurs et relire les incidents
Testez le contrôleur lui-même : distingue-t-il page disponible et action réussie ? Détecte-t-il une notification perdue ? Produit-il une alerte compréhensible et reçoit-elle une réponse ? N’exécutez des scénarios perturbateurs que dans un environnement autorisé. Les contrôles de production doivent éviter commandes fictives et messages involontaires.
Après un incident, reliez chronologie, impact, correctif et test de non-régression. Révisez l’indicateur si le défaut a échappé au contrôle. Le guide de réponse à un incident et le guide de vérification aident à attribuer les actions et conserver les résultats. Un objectif utile évolue avec le parcours et les risques observés.
Vérifier le retour à une liste après consultation d’une fiche et éviter les états périmés.
Cas fictif : une personne filtre une liste, ouvre une fiche puis utilise Précédent. Contrôlez la conservation utile des filtres et la fraîcheur des éléments sensibles après restauration. Le bfcache est différent du cache HTTP : ne déduisez pas son comportement d’un seul en-tête. N’allégez pas les protections des pages privées simplement pour améliorer un score de navigation.
- Le retour garde le contexte utile et les informations nécessitant une actualisation suivent une règle testée.
- web.dev Back/forward Cache
Explication du cache de navigation arrière et avant, qui peut restaurer une page avec son état sans chargement complet.
Documents de référence
- SRE Workbook de Google · Source consultée
- chapitre sur la politique de budget d’erreur
- web.dev Back/forward Cache · Source consultée
Contenu mis à jour le