
Temps de lecture estimé : 3 min · Publié le 1 octobre 2026
Partir des questions auxquelles répondre
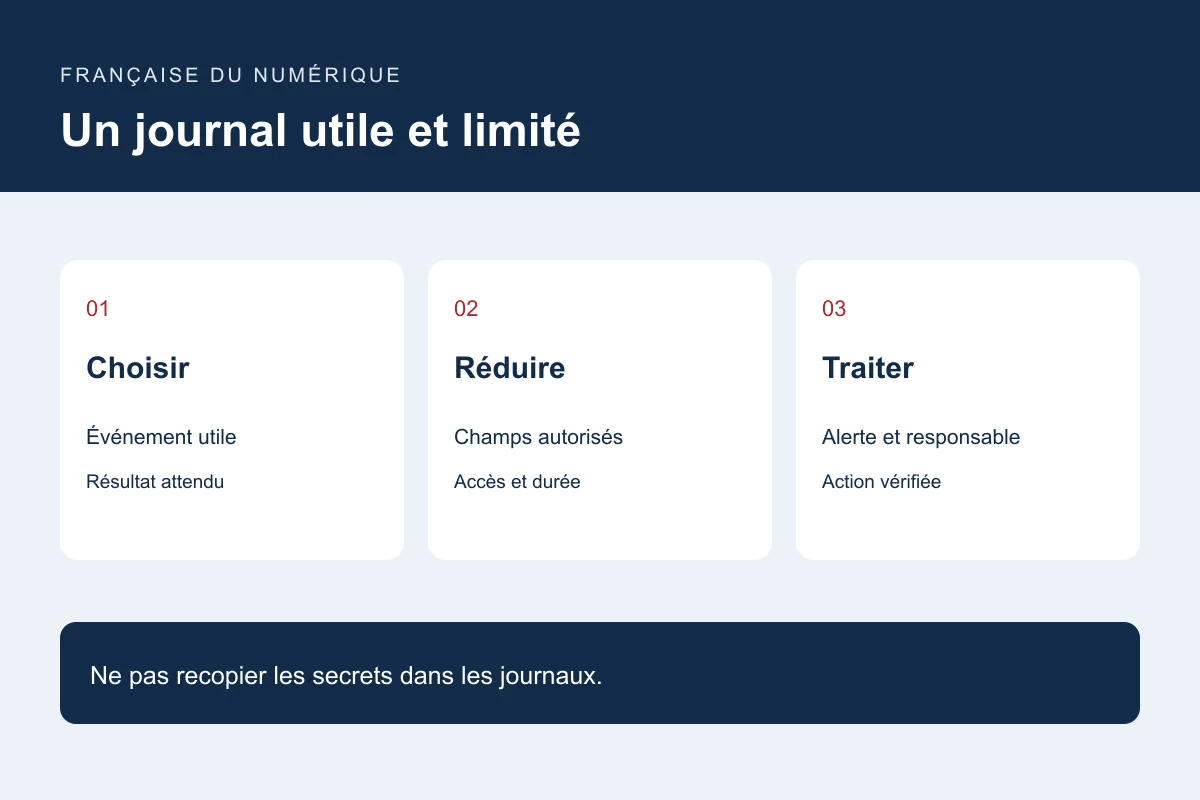
Listez des questions opérationnelles : le formulaire échoue-t-il, un traitement est-il interrompu, une sauvegarde a-t-elle été vérifiée ? Définissez pour chacune l’événement, le composant, l’heure et un identifiant de suivi approprié. Évitez les messages qui accumulent du texte sans permettre de retrouver une action.
Préparez des exemples synthétiques de réussite, de refus et d’échec. Un événement attendu doit être distingué d’une panne. Le niveau choisi et le nom de l’événement doivent aider le responsable à décider s’il doit enquêter ou simplement suivre une tendance.
Réduire les informations enregistrées
OWASP recommande d’examiner les données à exclure des journaux, notamment mots de passe, jetons d’accès et informations sensibles. Relisez les messages produits par votre propre code, mais aussi ceux des extensions, proxys et outils de suivi.
Proposez une liste de champs autorisés plutôt qu’une copie complète de la requête. Un identifiant de diagnostic peut suffire là où un message de contact entier serait excessif. Testez avec des marqueurs fictifs et recherchez ensuite ces marqueurs dans les sorties pour repérer une collecte involontaire.
Organiser accès, conservation et volume
Documentez qui peut lire les journaux et dans quel but. Vérifiez qu’ils ne sont pas servis depuis une adresse publique et que les outils de partage ne les rendent pas accessibles par défaut. Une exportation pour diagnostic doit suivre le même contrôle que le stockage principal.
Définissez une durée justifiée par le besoin et les règles applicables au contexte, sans reprendre une durée trouvée pour un autre service. Organisez rotation, limitation de volume et suppression. Une panne ne doit pas remplir un disque parce qu’un message se répète sans limite.
Tester le passage du signal à l’action
Déclenchez un échec contrôlé dans un environnement de test. Vérifiez le journal, la transmission de l’alerte, son destinataire et la procédure suivie. Une alerte délivrée à une boîte que personne ne consulte ne constitue pas un dispositif opérationnel.
Regroupez les répétitions et suivez les signaux qui permettent une décision. Après un incident, demandez ce qui manquait pour comprendre et ce qui était inutilement exposé. Le livrable utile associe un événement à une donnée minimale, un responsable et une action.
Documentation primaire : OWASP — Logging Cheat Sheet.