
Tempo de leitura estimado : 5 min · Publicado
Escolha a jornada para proteger
Descreva a ação essencial, o público e as dependências que podem interrompê-lo. Um site de negócios pode precisar que os visitantes leiam uma oferta e enviem consultas; Uma loja precisa de pedidos registrados corretamente. Separe o carregamento da página, a conclusão da ação e o manuseio subsequente, pois essas etapas podem falhar de forma diferente.
Os pasta de trabalho do google sre Descreve os objetivos do serviço com base em indicadores e concordância entre as partes interessadas. Adapte a abordagem ao tamanho do site. Uma pequena equipe pode começar com uma jornada, um indicador observável e um proprietário, em vez de muitos painéis sem decisões associadas.
Definir eventos e janelas de observação
Escreva o que conta como uma tentativa e sucesso, onde é observado e quais exclusões são justificadas. A entrada deliberadamente inválida difere da perda de uma consulta válida. O monitoramento sintético e o uso real observam populações diferentes; Mantenha seus resultados separados.
Defina a janela de leitura e o mínimo de evidência útil. As porcentagens são instáveis com poucos eventos em um site de baixo tráfego. Mostrar tentativas e falhas contabilizadas juntamente com a taxa e investigar casos reproduzíveis. Evite coletar mensagens desnecessárias ou informações pessoais para medir um resultado técnico.
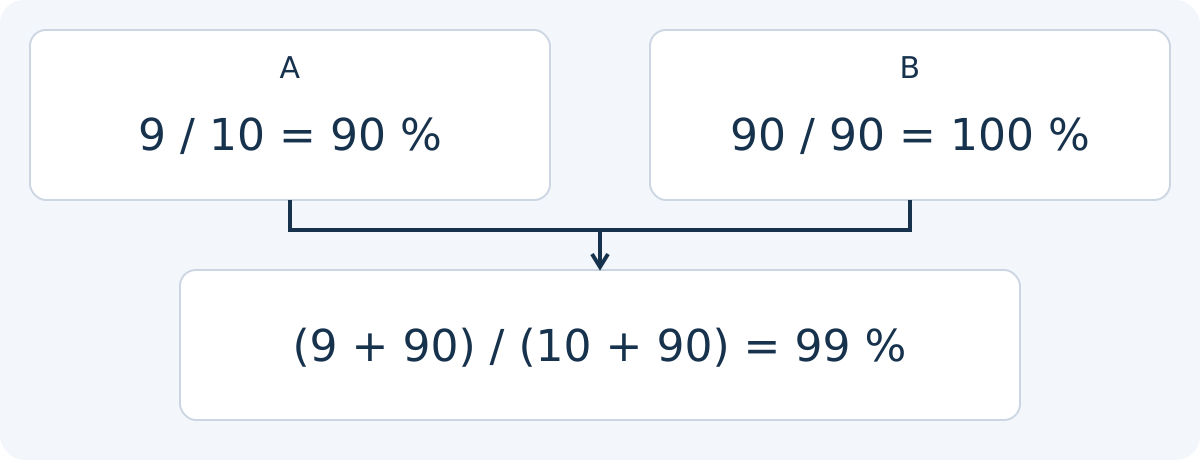
Conserve contagens ao agregar indicadores por eventos. Exemplo fictício: A tem 9 sucessos em 10 tentativas, 90 %; B tem 90 em 90, 100 %. Para grupos disjuntos, mesmo período e definição de sucesso, o total é (9 + 90) / (10 + 90) = 99 %. A média simples (90 + 100) / 2 = 95 % é a média das taxas dos grupos, não a taxa destas 100 tentativas.
SRE Workbook apresenta eventos satisfatórios divididos por todos os selecionados. Antes de somar confira duplicados, janela, exclusões e definição de tentativa: uma repetição pode ser mais um evento sem novo pedido do visitante. Guarde taxas de grupo se o total ocultar um obstáculo local. Sem tentativas observadas a taxa é indeterminada; interrupção de recolha limita cobertura, não prova zero falhas. Estas razões não medem automaticamente disponibilidade temporal.
Desloque a tabela horizontalmente para ler todas as colunas. Com o teclado, coloque o foco na tabela e utilize as teclas de seta.
| População ou cálculo | Sucessos / tentativas | Interpretação |
|---|---|---|
| Grupo A | 9 / 10 | 90 % |
| Grupo B | 90 / 90 | 100 % |
| Total de tentativas | 99 / 100 | 99 % |
| Média simples das duas taxas | (90 + 100) / 2 = 95 % | Peso igual por grupo, não por tentativa |
Escolha um objetivo antes de assumir um compromisso
Um objetivo interno descreve um nível desejado e orienta as decisões. Um compromisso contratual tem alcance e consequências que exigem um acordo separado. Evite adotar uma alta porcentagem apenas porque parece reconfortante. Compare as necessidades dos visitantes, as restrições operacionais e os custos de recuperação.
Em um cálculo ficcional, 10 falhas entre 1.000 tentativas produzem 99% de sucesso. Isso não descreve a duração, as pessoas afetadas ou a gravidade: contagens idênticas podem representar inconveniências menores ou pedidos perdidos. A disponibilidade baseada em tempo requer uma definição diferente; Não converta indicadores sem explicar o método.
Conectar limites às ações
Decida quem investiga os alertas, quais evidências estabelecem um incidente e como as pessoas afetadas são informadas. Uma interrupção confirmada pode exigir uma solução alternativa ou uma reversão. Um alerta isolado pode precisar de verificação antes do escalonamento. Reduza a incerteza e o tempo de resposta, em vez de gerar mensagens para cada flutuação.
A qualidade do documento diminui durante as alterações. Os Capítulo de política de orçamento de erro Descreve as respostas acordadas a lacunas de confiabilidade. Um pequeno site pode simplesmente atrasar uma mudança opcional até que um defeito crítico seja resolvido sem reivindicar a implementação do modelo operacional de um grande serviço.
Verifique os observadores e revise os incidentes
Test Monitoring em si: distingue a disponibilidade da página das ações concluídas? Ele pode detectar uma notificação perdida? Ele emite um alerta compreensível que recebe uma resposta? Cenários disruptivos pertencem a ambientes autorizados. As verificações de produção devem evitar pedidos fictícios e mensagens acidentais.
Após incidentes, conecte cronogramas, impacto, correções e verificações de regressão. Revise os indicadores se as falhas escaparem à detecção. Os Guia de resposta a incidentes e Guia de pré-lançamento Ajude a atribuir ações e reter as descobertas. Objetivos úteis evoluem com jornadas e riscos observados.
Verificar o regresso a uma lista evitando estados desatualizados.
Caso fictício: alguém filtra uma lista, abre uma ficha e volta atrás. Verifique filtros e atualização de informação sensível. bfcache não é cache HTTP: um cabeçalho não basta para explicar o comportamento. Não enfraqueça proteções privadas para melhorar uma pontuação.
- O regresso conserva o contexto útil e atualiza informação conforme uma regra testada.
- web.dev Back/forward Cache
Explicação da cache de navegação que pode restaurar uma página e o seu estado.
Documentos de referência
- pasta de trabalho do google sre · Fonte consultada
- Capítulo de política de orçamento de erro
- web.dev Back/forward Cache · Fonte consultada
Conteúdo atualizado