
Tempo di lettura stimato : 5 min · Pubblicato
Scegli il viaggio da proteggere
Descrivi l'azione essenziale, il pubblico e le dipendenze che possono interromperla. Un sito aziendale potrebbe aver bisogno di visitatori per leggere un'offerta e inviare richieste; Un negozio ha bisogno di ordini registrati correttamente. Caricamento pagina separato, completamento delle azioni e gestione successiva perché questi passaggi possono fallire in modo diverso.
Le cartella di lavoro sre di google Descrive gli obiettivi di servizio basati su indicatori e accordi tra le parti interessate. Adatta l'approccio alle dimensioni del sito. Un piccolo team può iniziare con un viaggio, un indicatore osservabile e un proprietario piuttosto che molti dashboard senza decisioni associate.
Definire eventi e finestre di osservazione
Scrivi ciò che conta come un tentativo e un successo, dove viene osservato e quali esclusioni sono giustificate. L'input deliberatamente non valido differisce dalla perdita di una richiesta valida. Il monitoraggio sintetico e l'uso effettivo osservano diverse popolazioni; mantenere i loro risultati separati.
Definire la finestra di lettura e le prove utili minime. Le percentuali sono instabili con pochi eventi su un sito a basso traffico. Mostra il conteggio del tentativo e del fallimento insieme al tasso e indaga sui casi riproducibili. Evita di raccogliere messaggi o informazioni personali non necessari per misurare un risultato tecnico.
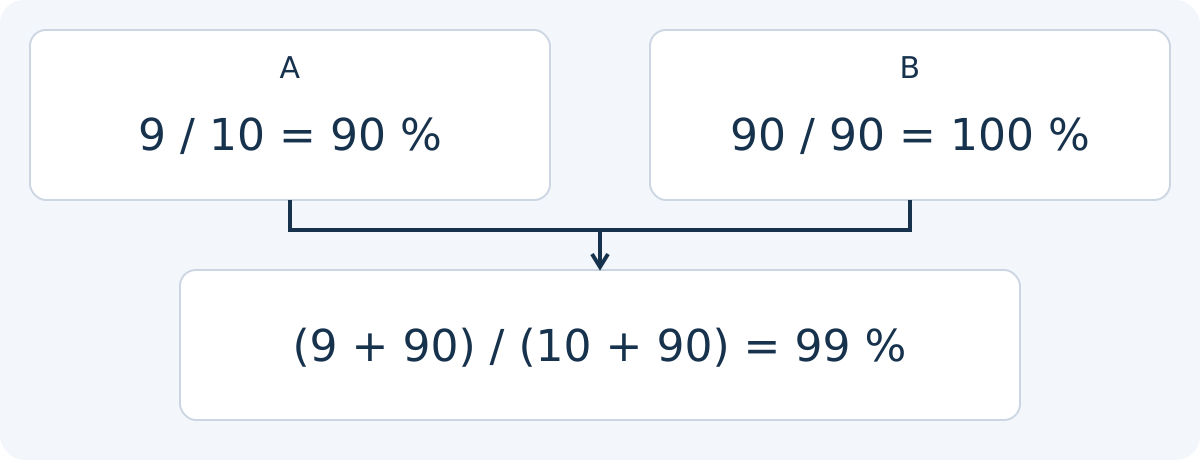
Conservate i conteggi nell’aggregazione di indicatori per eventi. Esempio fittizio: A ha 9 successi su 10 tentativi, 90 %; B 90 su 90, 100 %. Con gruppi disgiunti, stesso periodo e definizione di successo il totale è (9 + 90) / (10 + 90) = 99 %. La media semplice (90 + 100) / 2 = 95 % è una media dei tassi di gruppo, non il tasso di quei 100 tentativi.
SRE Workbook presenta eventi soddisfacenti divisi per tutti gli eventi selezionati. Prima di sommare verificate duplicati, finestra, esclusioni e definizione del tentativo: una ripetizione può aggiungere un evento senza essere nuova richiesta del visitatore. Mantenete i tassi di gruppo se il totale nasconde un ostacolo locale. Senza tentativi osservati il tasso è indeterminato; una raccolta interrotta limita la copertura, non prova zero errori. Questi rapporti non misurano automaticamente disponibilità temporale.
Scorri la tabella orizzontalmente per leggere tutte le colonne. Con la tastiera, porta il focus sulla tabella e usa i tasti freccia.
| Popolazione o calcolo | Successi / tentativi | Interpretazione |
|---|---|---|
| Gruppo A | 9 / 10 | 90 % |
| Gruppo B | 90 / 90 | 100 % |
| Totale tentativi | 99 / 100 | 99 % |
| Media semplice dei due tassi | (90 + 100) / 2 = 95 % | Uguale peso per gruppo, non per tentativo |
Scegli un obiettivo prima di prendere un impegno
Un obiettivo interno descrive un livello desiderato e guida le decisioni. Un impegno contrattuale ha portata e conseguenze che richiedono un accordo separato. Evita di adottare un'alta percentuale semplicemente perché sembra rassicurante. Confronta le esigenze dei visitatori, i vincoli operativi e i costi di recupero.
In un calcolo immaginario, 10 fallimenti su 1.000 tentativi producono il 99% di successo. Questo non descrive la durata, le persone colpite o la gravità: conteggi identici possono rappresentare piccoli disagi o ordini perduti. La disponibilità basata sul tempo richiede una definizione diversa; Non convertire gli indicatori senza spiegare il metodo.
Collega le soglie alle azioni
Decidi chi indaga sugli avvisi, quali prove stabiliscono un incidente e come le persone colpite vengono informate. Un'interruzione confermata potrebbe richiedere una soluzione alternativa o un rollback. Un avviso isolato potrebbe richiedere la verifica prima dell'escalation. ridurre l'incertezza e il tempo di risposta piuttosto che generare messaggi per ogni fluttuazione.
La qualità del documento diminuisce durante i cambiamenti. Le Capitolo della politica del budget di errore Descrive le risposte concordate alle lacune di affidabilità. Un piccolo sito potrebbe semplicemente ritardare una modifica facoltativa fino a quando un difetto critico non viene risolto senza pretendere di implementare il modello operativo di un servizio di grandi dimensioni.
Verificare gli osservatori e rivedere gli incidenti
Monitoraggio del test stesso: distingue la disponibilità della pagina dalle azioni completate? Può rilevare una notifica persa? Emette un avviso comprensibile che riceve una risposta? Gli scenari dirompenti appartengono ad ambienti autorizzati. I controlli di produzione devono evitare ordini di fantasia e messaggi accidentali.
Dopo gli incidenti, collegare le linee temporali, l'impatto, le correzioni e i controlli di regressione. Rivedere gli indicatori se i guasti sono fuggiti dal rilevamento. Le Guida alla risposta agli incidenti e Guida al pre-lancio Aiuta ad assegnare azioni e conservare i risultati. Gli obiettivi utili si evolvono con viaggi e rischi osservati.
Verificare il ritorno a un elenco evitando stati obsoleti.
Caso fittizio: una persona filtra un elenco, apre una scheda e torna indietro. Verificate filtri e freschezza delle informazioni sensibili. bfcache non è cache HTTP: una sola intestazione non ne descrive il comportamento. Non indebolite protezioni private per migliorare un punteggio.
- Il ritorno conserva il contesto utile e aggiorna ciò che richiede una regola verificata.
- web.dev Back/forward Cache
Spiegazione della cache avanti/indietro che può ripristinare pagina e stato senza ricaricarli interamente.
Documenti di riferimento
- cartella di lavoro sre di google · Fonte consultata
- Capitolo della politica del budget di errore
- web.dev Back/forward Cache · Fonte consultata
Contenuto aggiornato