
Geschätzte Lesezeit : 4 min · Veröffentlicht
Definieren Sie eine Aufgabe und ihre erforderliche Qualität
Wählen Sie eine bestimmte Aufgabe: Schlagen Sie Überschriften vor, klassifizieren Sie Anfragen, übersetzen Sie eine Seite oder antworten Sie aus der Dokumentation. Definieren Sie das erwartete Ergebnis und was einen signifikanten Fehler darstellen würde. Interne Schreibunterstützung hat andere Konsequenzen als eine öffentliche Antwort auf Preis, Zeit oder Vertragsbedingungen.
Die NIST AI-Risikomanagement-Framework und sein generative-AI-Profil bieten Referenzen für die Organisation der Bewertung. Sie genehmigen kein bestimmtes Produkt. Ihre Kriterien sollten Risiken mit der Aufgabe, der Zielgruppe und der Verwendung ihrer Ausgabe verbinden.
- Aufgabe und Publikum.
- nachprüfbares Ergebnis.
- akzeptable und blockierende Fehler.
- Entscheidungsinhaber.
Überprüfen Sie die Daten und den Exit-Pfad
Listen Sie die an den Dienst gesendeten Daten, Personen, die darauf zugreifen können, Aufbewahrungsregeln und angegebene Nutzungsbedingungen auf. Überprüfen Sie diese in der Dokumentation und dem Vertrag des Lieferanten. Gehen Sie nicht davon aus, dass jedes Produkt eines Unternehmens die gleichen Bedingungen hat. Ein Verbraucherkonto, API und ein Unternehmensplan können unterschiedlich sein.
Bereiten Sie anonymisierte oder klar gekennzeichnete synthetische Beispiele für Erstversuche vor. Definieren Sie, was exportiert werden kann, wie Lieferanten gewechselt werden können und welche Aufgabe während eines Ausfalls möglich bleibt. Speichern Sie Anweisungen, Quellen und Bewertungen, damit das nächste Projektteam sie verstehen kann.
- Daten zum Testen zulässig.
- angebotsspezifische Bedingungen.
- Zugriff, Aufbewahrung und Export.
- Manueller Fallback.
Bauen Sie ein kleines, aber anspruchsvolles Testset
Sammeln Sie repräsentative und schwierige Fälle: Fehlende Informationen, widersprüchliche Quellen, Mehrdeutigkeit, eine andere Sprache und Versuche, Anweisungen umzuleiten. Definieren Sie vor dem Testen Referenzantworten oder Akzeptanzkriterien. Ein Tool, das sich weigert zu antworten, wenn Informationen fehlen, kann nützlicher sein als eines, das eine überzeugende Erfindung hervorbringt.
Messen Sie die Genauigkeit, Auslassungen, Referenzen, Latenz und Kosten im ausgewählten Szenario. Überprüfen Sie mehrere Ausgaben, da die Generierung variieren kann. Behalten Sie das Modell oder die Angebotsversion bei, wenn bekannt, nützliche Einstellungen, Testdatum und Beispiele. Eine einzelne Gesamtpunktzahl sollte kein Versagen einer wesentlichen Aufgabe verbergen.
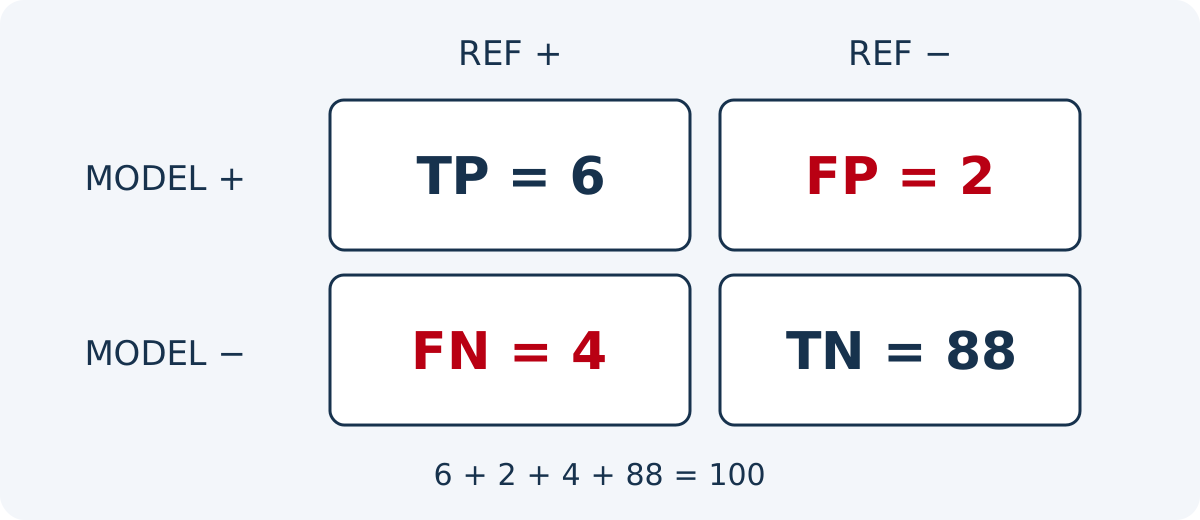
Fiktive Klassifikationsübung für Anfragen, ohne einem Werkzeug Ergebnisse zuzuschreiben: Von 100 Referenzfällen benötigen 10 menschliche Prüfung und 90 nicht. Die Regel markiert 8: 6 tatsächlich prüfbedürftige Fälle (TP) und 2 Fehlalarme (FP). Sie übersieht 4 prüfbedürftige Fälle (FN) und schließt die übrigen 88 korrekt aus (TN). Die Gesamtgenauigkeit, accuracy, beträgt (6 + 88) / 100 = 94 %. Die Präzision der Meldungen, precision, beträgt aber 6 / 8 = 75 %, die Trefferquote, recall, nur 6 / 10 = 60 %.
Die Kennzahlen beantworten unterschiedliche Fragen: korrekte Entscheidungen, berechtigte Meldungen und gefundene Zielfälle. Googles Klassifikationskurs erklärt die Nenner; hohe accuracy kann übersehene seltene Fälle verdecken. Positivdefinition, gegebenenfalls Schwellenwert und Referenzmenge vor dem Vergleich festlegen und alle vier Anzahlen aufbewahren. Bei Nenner null ist der Bruch undefiniert; daraus nicht willkürlich Erfolg machen. Diese Klassifikationsmaße messen allein weder die sachliche Qualität erzeugter Texte noch allgemeine Zuverlässigkeit.
- repräsentative und Randfälle.
- Vor dem Test vereinbarte Kriterien.
- Fehler pro Beispiel dokumentiert.
- Testversion und Datum.
Scrollen Sie die Tabelle horizontal, um alle Spalten zu lesen. Mit der Tastatur fokussieren Sie den Tabellenbereich und verwenden die Pfeiltasten.
| Kennzahl | Berechnung im fiktiven Datensatz | Bedeutung des Nenners |
|---|---|---|
| Gesamtgenauigkeit (accuracy) | (6 + 88) / 100 = 94 % | Alle richtigen und falschen Klassifikationen |
| Präzision der Meldungen (precision) | 6 / (6 + 2) = 75 % | Die acht markierten Fälle |
| Trefferquote (recall) | 6 / (6 + 4) = 60 % | Die zehn tatsächlich prüfbedürftigen Fälle |
| Übersehene Prüffälle (FN) | FN = 4 | Vier tatsächliche Positive ohne Meldung |
Begrenzen Sie die Bereitstellung und Neubewertung im Laufe der Zeit
Beginnen Sie mit überprüften Ausgaben. Beschränken Sie für einen öffentlichen Assistenten mögliche Aktionen, stellen Sie Quellen zur Verfügung und stellen Sie einen menschlichen Kontakt bereit, wenn eine Anfrage nicht zuständig ist. Testen Sie die Wiederherstellung nach Ausfällen, ungültigen Antworten und Dokumentänderungen. Beobachten Sie die Ergebnisse, ohne unnötig personenbezogene Daten aufzubewahren.
Wiederholen Sie die Tests, wenn sich Modelle, Anweisungen, Dokumentationen oder Funktionen ändern. Die Source-Verifikations-Anleitung Unterstützt die redaktionelle Überprüfung. DieAI-Ressourcenverzeichnis Bietet offizielle Ausgangspunkte für den Vergleich von Dienstleistungen, ohne deren Ergebnisse zu garantieren.
Referenzdokumente
- NIST AI-Risikomanagement-Framework · Quelle eingesehen
- Google ML : Accuracy, recall and precision · Quelle eingesehen
Inhalt aktualisiert