
Tempo de leitura estimado : 4 min · Publicado
Definir uma tarefa e sua qualidade exigida
Escolha uma tarefa específica: sugira títulos, classifique as consultas, traduza uma página ou uma resposta da documentação. Defina o resultado esperado e o que constituiria um erro significativo. A assistência à redação interna tem consequências diferentes em relação a uma resposta pública sobre preços, prazos ou termos contratuais.
Os Estrutura de gerenciamento de risco da AI do NIST e seu perfil generativo-IA oferece referências para a avaliação de organização. Eles não aprovam um determinado produto. Seus critérios devem conectar os riscos à tarefa, ao público e ao uso de sua saída.
- tarefa e público.
- resultado verificável.
- erros aceitáveis e de bloqueio.
- Proprietário da decisão.
Revisar dados e o caminho de saída
Liste os dados enviados ao serviço, pessoas que podem acessá-los, regras de retenção e termos de uso declarados. Verifique isso na documentação e contrato do fornecedor. Não assuma que todos os produtos de uma empresa têm as mesmas condições. Uma conta de consumidor, uma API e um plano corporativo podem ser diferentes.
Prepare exemplos sintéticos anonimizados ou claramente rotulados para testes iniciais. Defina o que pode ser exportado, como mudar de fornecedor e qual tarefa permanece possível durante uma interrupção. Armazene instruções, fontes e avaliações para que a próxima equipe do projeto possa entendê-las.
- Dados permitidos para testes.
- termos específicos para a oferta.
- Acesso, retenção e exportação.
- fallback manual.
Construa um conjunto de testes pequeno, mas exigente
Colete casos representativos e difíceis: informações ausentes, fontes conflitantes, ambiguidade, outro idioma e tentativas de desvio de instruções. Defina as respostas de referência ou os critérios de aceitação antes do teste. Uma ferramenta que se recusa a responder quando faltam informações pode ser mais útil do que aquela que produz uma invenção convincente.
Meça a precisão, omissões, referências, latência e custo separadamente no cenário escolhido. Revise as saídas múltiplas porque a geração pode variar. Mantenha o modelo ou a versão da oferta quando conhecido, configurações úteis, datas de teste e exemplos. Uma única pontuação total não deve ocultar a falha em uma tarefa essencial.
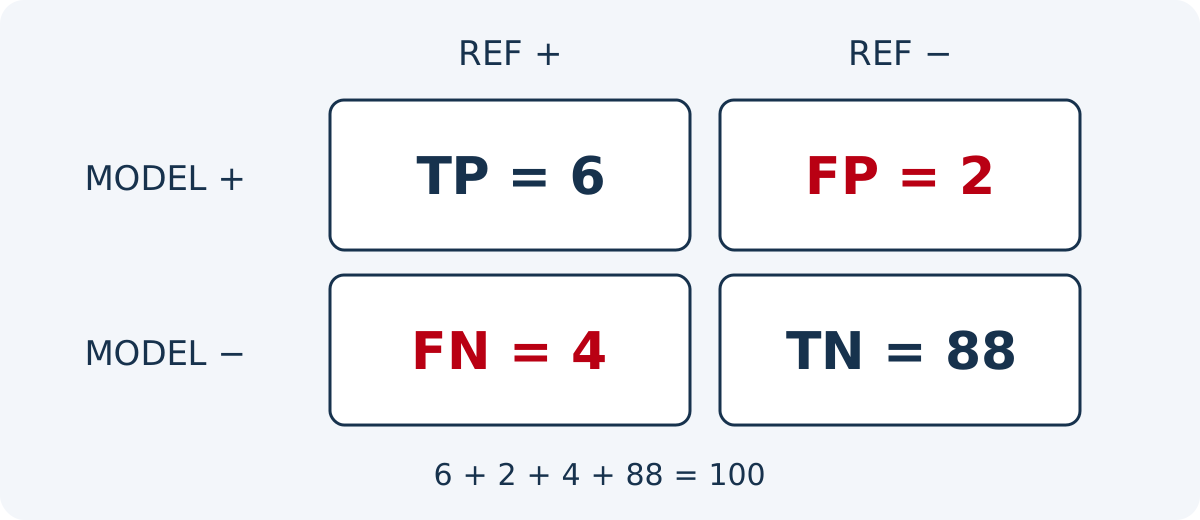
Exercício fictício de classificação de pedidos, sem atribuir resultados a uma ferramenta: de 100 casos de referência, 10 exigem revisão humana e 90 não. A regra assinala 8: 6 realmente a rever (TP) e 2 falsos alarmes (FP). Falha 4 casos a rever (FN) e exclui corretamente os outros 88 (TN). A exatidão global, accuracy, é (6 + 88) / 100 = 94 %. A precisão dos alertas, precision, é porém 6 / 8 = 75 % e a sensibilidade, recall, apenas 6 / 10 = 60 %.
As métricas respondem a perguntas distintas: decisões corretas, alertas justificados e casos-alvo encontrados. O curso de classificação Google explica os denominadores; accuracy elevada pode esconder casos raros falhados. Fixe definição do positivo, eventual limiar e conjunto de referência antes de comparar e guarde as quatro contagens. Um denominador zero torna a fração indefinida; não o transforme arbitrariamente em sucesso. Estas métricas de classificação não medem, por si só, qualidade factual de texto gerado nem fiabilidade geral.
- Casos representativos e de borda.
- Os critérios acordados antes do teste.
- Erros documentados por exemplo.
- Versão de teste e data.
Desloque a tabela horizontalmente para ler todas as colunas. Com o teclado, coloque o foco na tabela e utilize as teclas de seta.
| Métrica | Cálculo no conjunto fictício | Significado do denominador |
|---|---|---|
| Exatidão global (accuracy) | (6 + 88) / 100 = 94 % | Todas as classificações, corretas ou incorretas |
| Precisão dos alertas (precision) | 6 / (6 + 2) = 75 % | Os oito casos assinalados |
| Sensibilidade (recall) | 6 / (6 + 4) = 60 % | Os dez casos que exigiam revisão |
| Casos falhados (FN) | FN = 4 | Quatro positivos reais sem alerta |
Limite a implantação e reavalie ao longo do tempo
Comece com as saídas revisadas. Para um Assistente Público, restrinja as ações possíveis, disponibilize fontes e forneça um contato humano quando uma solicitação estiver fora de seu mandato. Teste a recuperação após interrupções, respostas inválidas e alterações de documentos. Observe os resultados sem reter desnecessariamente os dados pessoais.
Repita os testes quando os modelos, instruções, documentação ou recursos mudam. Os Guia de verificação de origem Suporta revisão editorial. OsDiretório de recursos da AI Oferece pontos de partida oficiais para comparar serviços sem garantir seus resultados.
Documentos de referência
- Estrutura de gerenciamento de risco da AI do NIST · Fonte consultada
- Google ML : Accuracy, recall and precision · Fonte consultada
Conteúdo atualizado