
وقت القراءة المقدر : 4 min · تاريخ النشر
تحديد المهمة والجودة المطلوبة
اختر مهمة محددة: اقتراح العناوين أو تصنيف الاستفسارات أو ترجمة صفحة أو إجابة من الوثائق. حدد النتيجة المتوقعة وما الذي سيشكل خطأ كبير. المساعدة في الكتابة الداخلية لها عواقب مختلفة عن الإجابة العامة حول السعر أو التوقيت أو الشروط التعاقدية.
ال إطار إدارة المخاطر NIST AI ويقدم ملف تعريف الذكاء الاصطناعي التوليدي مراجع لتنظيم التقييم. إنهم لا يوافقون على منتج معين. يجب أن تربط معاييرك بالمهمة والجمهور واستخدام مخرجاتها.
- المهمة والجمهور.
- نتيجة يمكن التحقق منها.
- أخطاء مقبولة وحجب.
- صاحب القرار.
مراجعة البيانات ومسار الخروج
سرد البيانات المرسلة إلى الخدمة والأشخاص الذين يمكنهم الوصول إليها وقواعد الاحتفاظ وشروط الاستخدام المحددة. تحقق من ذلك في وثائق المورد وعقده. لا تفترض أن كل منتج من شركة واحدة لديه نفس الشروط. قد يختلف حساب المستهلك وواجهة برمجة التطبيقات وخطة المؤسسة.
قم بإعداد أمثلة اصطناعية مجهولة المصدر أو موصوفة بوضوح للتجارب الأولية. حدد ما يمكن تصديره وكيفية تغيير الموردين والمهمة التي تظل ممكنة أثناء الانقطاع. قم بتخزين التعليمات والمصادر والتقييمات حتى يتمكن فريق المشروع التالي من فهمها.
- البيانات المسموح بها للاختبار.
- شروط خاصة بالعرض.
- الوصول والاحتفاظ والتصدير.
- احتياطي يدوي.
قم ببناء مجموعة اختبار صغيرة ولكنها متطلبة
جمع حالات تمثيلية وحالات صعبة: معلومات مفقودة ، ومصادر متضاربة ، وغموض ، ولغة أخرى ، ومحاولات تحويل التعليمات. حدد الإجابات المرجعية أو معايير القبول قبل الاختبار. قد تكون الأداة التي ترفض الإجابة عند فقدان المعلومات أكثر فائدة من الأداة التي تنتج اختراعًا مقنعًا.
قياس الدقة والسهو والمراجع والكمون والتكلفة بشكل منفصل في السيناريو المختار. راجع مخرجات متعددة لأن التوليد قد يختلف. احتفظ بالطراز أو إصدار العرض عندما يكون معروفًا والإعدادات المفيدة وتاريخ الاختبار والأمثلة. يجب ألا تخفي النتيجة الإجمالية الفشل في مهمة أساسية.
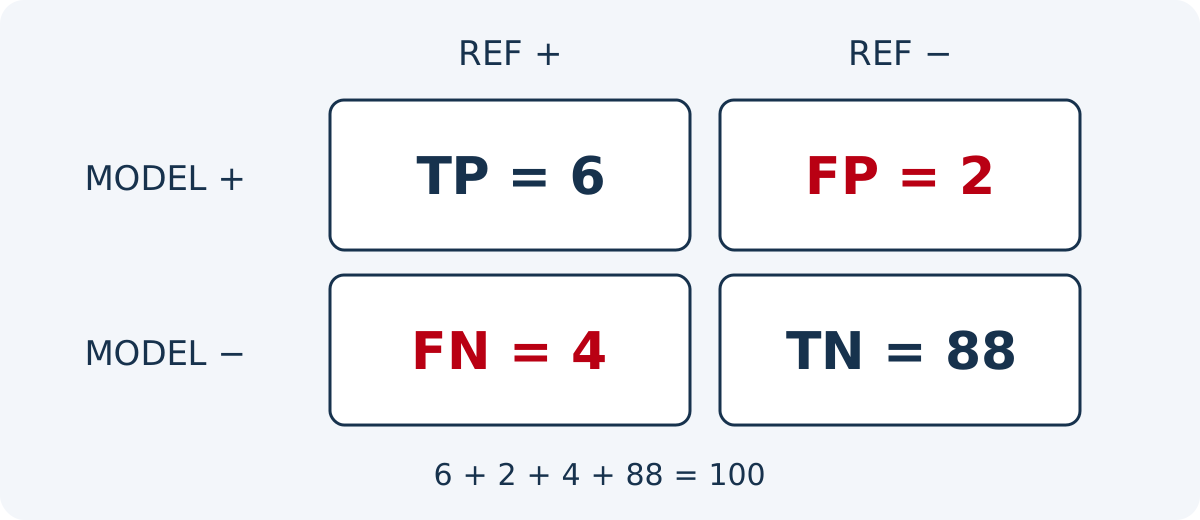
تمرين افتراضي لتصنيف الطلبات دون نسبة نتيجة إلى أداة: من أصل 100 حالة مرجعية تحتاج 10 إلى مراجعة بشرية ولا تحتاج 90 إليها. تشير القاعدة إلى 8 حالات: 6 تستحق المراجعة فعلًا (TP) و2 إنذاران خاطئان (FP). وتفوتها 4 حالات تستحق المراجعة (FN) وتستبعد الحالات الأخرى البالغ عددها 88 بصورة صحيحة (TN). تبلغ نسبة التصنيفات الصحيحة accuracy ما يعادل (6 + 88) / 100 = 94 %. لكن دقة الإنذارات precision تساوي 6 / 8 = 75 % والاسترجاع recall يساوي فقط 6 / 10 = 60 %.
تجيب المقاييس عن أسئلة مختلفة: القرارات الصحيحة والإنذارات المبررة والحالات المستهدفة المكتشفة. يشرح درس Google للتصنيف مقاماتها؛ وقد تخفي accuracy مرتفعة حالات نادرة فائتة. ثبّت تعريف الحالة الإيجابية والعتبة إن وجدت والمجموعة المرجعية قبل المقارنة واحفظ الأعداد الأربعة. المقام صفر يجعل الكسر غير معرف؛ لا تحوله اعتباطًا إلى نجاح. لا تقيس مؤشرات التصنيف وحدها صحة الحقائق في نص مولد أو الموثوقية العامة.
- حالات التمثيل والحافة.
- المعايير المتفق عليها قبل الاختبار.
- أخطاء موثقة في كل مثال.
- النسخة التجريبية والتاريخ.
مرّر الجدول أفقيًا لقراءة جميع الأعمدة. باستخدام لوحة المفاتيح، انقل التركيز إلى الجدول ثم استخدم مفاتيح الأسهم.
| المقياس | الحساب على المجموعة الافتراضية | ما يمثله المقام |
|---|---|---|
| صحة التصنيف العامة (accuracy) | (6 + 88) / 100 = 94 % | كل التصنيفات الصحيحة والخاطئة |
| دقة الإنذارات (precision) | 6 / (6 + 2) = 75 % | الحالات الثماني المشار إليها |
| الاسترجاع (recall) | 6 / (6 + 4) = 60 % | الحالات العشر التي احتاجت مراجعة |
| حالات مراجعة فائتة (FN) | FN = 4 | أربع حالات إيجابية فعلية لم تُشر إليها القاعدة |
الحد من النشر وإعادة التقييم بمرور الوقت
ابدأ بالمخرجات التي تمت مراجعتها. بالنسبة للمساعد العام ، قم بتقييد الإجراءات الممكنة ، وإتاحة المصادر ووفر جهة اتصال بشرية عندما يكون الطلب خارج تنازله. استرداد الاختبار بعد الانقطاعات والإجابات غير الصالحة وتغييرات المستندات. راقب النتائج دون الاحتفاظ بالبيانات الشخصية دون داع.
كرر الاختبارات عند تغيير النماذج أو التعليمات أو الوثائق أو القدرات. ال دليل التحقق من المصدر يدعم المراجعة التحريرية. الدليل موارد الذكاء الاصطناعي يقدم نقاط بداية رسمية لمقارنة الخدمات دون ضمان نتائجها.
المستندات المرجعية
- إطار إدارة المخاطر NIST AI · مصدر تمت مراجعته
- Google ML : Accuracy, recall and precision · مصدر تمت مراجعته
تاريخ تحديث المحتوى