
Geschatte leestijd : 4 min · Gepubliceerd
Definieer een taak en de vereiste kwaliteit
Kies een specifieke taak: stel koppen voor, classificeer vragen, vertaal een pagina of antwoord vanuit de documentatie. Definieer het verwachte resultaat en wat een significante fout zou zijn. Interne schrijfhulp heeft verschillende gevolgen dan een openbaar antwoord over prijs, timing of contractuele voorwaarden.
De NIST AI-risicobeheerkader en het generatieve-AI-profiel bieden referenties voor het organiseren van beoordeling. Ze keuren een bepaald product niet goed. Uw criteria moeten risico's verbinden met de taak, het publiek en het gebruik van de output.
- taak en publiek.
- verifieerbare uitkomst.
- acceptabele en blokkerende fouten.
- beslissing eigenaar.
Bekijk gegevens en het exit-pad
Geef een lijst van gegevens die naar de service zijn verzonden, mensen die er toegang toe hebben, bewaarregels en vermelde gebruiksvoorwaarden. Controleer deze in de documentatie en het contract van de leverancier. Ga er niet vanuit dat elk product van één bedrijf dezelfde voorwaarden heeft. Een consumentenaccount, API en ondernemingsplan kunnen verschillen.
Bereid geanonimiseerde of duidelijk gelabelde synthetische voorbeelden voor voor de eerste proeven. Definieer wat er kan worden geëxporteerd, hoe u van leverancier kunt veranderen en welke taak mogelijk blijft tijdens een storing. Bewaar instructies, bronnen en evaluaties, zodat het volgende projectteam ze kan begrijpen.
- Gegevens toegestaan voor testen.
- Voorwaarden die specifiek zijn voor het aanbod.
- Toegang, retentie en export.
- Handmatige terugval.
Bouw een kleine maar veeleisende testset
Verzamel representatieve en moeilijke gevallen: ontbrekende informatie, tegenstrijdige bronnen, dubbelzinnigheid, een andere taal en pogingen om instructies om te leiden. Definieer referentieantwoorden of acceptatiecriteria voordat u gaat testen. Een hulpmiddel dat weigert te antwoorden wanneer informatie ontbreekt, kan nuttiger zijn dan een hulpmiddel dat een overtuigende uitvinding oplevert.
Meet nauwkeurigheid, weglatingen, referenties, latentie en kosten afzonderlijk in het gekozen scenario. Bekijk meerdere outputs omdat de opwekking kan variëren. Bewaar het model of de aanbiedingsversie indien bekend, nuttige instellingen, testdatum en voorbeelden. Een enkele totaalscore mag het falen van een essentiële taak niet verbergen.
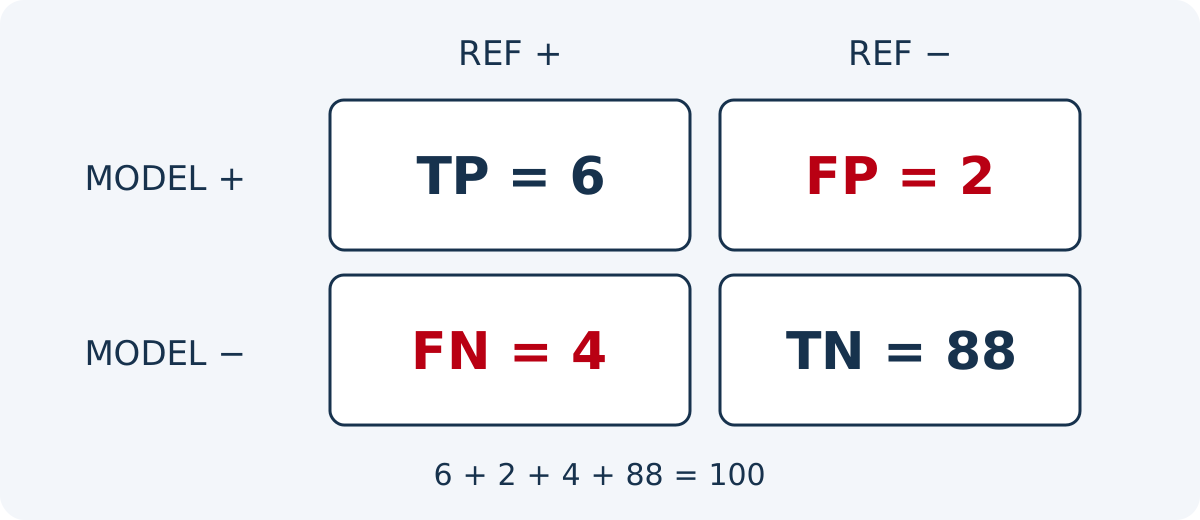
Fictieve classificatieoefening voor aanvragen, zonder resultaten aan een hulpmiddel toe te schrijven: van 100 referentiegevallen vragen er 10 menselijke controle en 90 niet. De regel markeert er 8: 6 terecht (TP) en 2 valse alarmen (FP). Hij mist 4 controlebehoevende gevallen (FN) en sluit de overige 88 correct uit (TN). De totale juistheid, accuracy, is (6 + 88) / 100 = 94 %. De precisie van meldingen, precision, is echter 6 / 8 = 75 % en de recall slechts 6 / 10 = 60 %.
Deze maten beantwoorden verschillende vragen: correcte beslissingen, terechte meldingen en gevonden doelgevallen. Googles classificatiecursus verklaart de noemers; hoge accuracy kan gemiste zeldzame gevallen verhullen. Leg positieve klasse, eventuele drempel en referentieset vooraf vast en bewaar de vier aantallen. Een nulnoemer maakt de breuk ongedefinieerd; maak daar niet willekeurig succes van. Deze classificatiematen meten op zichzelf geen feitelijke kwaliteit van gegenereerde tekst of algemene betrouwbaarheid.
- Representatieve en randgevallen.
- Criteria overeengekomen vóór het testen.
- Fouten gedocumenteerd per voorbeeld.
- Testversie en datum.
Schuif de tabel horizontaal om alle kolommen te lezen. Zet met het toetsenbord de focus op de tabel en gebruik de pijltjestoetsen.
| Maatstaf | Berekening op de fictieve set | Betekenis van de noemer |
|---|---|---|
| Totale juistheid (accuracy) | (6 + 88) / 100 = 94 % | Alle classificaties, juist of onjuist |
| Precisie van meldingen (precision) | 6 / (6 + 2) = 75 % | De acht gemarkeerde gevallen |
| Recall | 6 / (6 + 4) = 60 % | De tien gevallen die controle vroegen |
| Gemiste controlegevallen (FN) | FN = 4 | Vier echte positieven zonder melding |
Beperk de implementatie en herbeoordeel in de loop van de tijd
Begin met beoordeelde outputs. Voor een openbare assistent, beperk mogelijke acties, stel bronnen beschikbaar en zorg voor een menselijk contact wanneer een verzoek buiten zijn opdracht valt. Testherstel na storingen, ongeldige antwoorden en documentwijzigingen. Observeer uitkomsten zonder onnodig persoonsgegevens te bewaren.
Herhaal de tests wanneer modellen, instructies, documentatie of mogelijkheden veranderen. De Gids voor bronverificatie Ondersteunt redactionele beoordeling. DeAI-resourcemap Biedt officiële uitgangspunten voor het vergelijken van diensten zonder hun resultaten te garanderen.
Referentiedocumenten
- NIST AI-risicobeheerkader · Bron geraadpleegd
- Google ML : Accuracy, recall and precision · Bron geraadpleegd
Inhoud bijgewerkt