
Tempo di lettura stimato : 4 min · Pubblicato
Definire un compito e la sua qualità richiesta
Scegli un compito specifico: suggerisci intestazioni, classifica le richieste, traduci una pagina o una risposta dalla documentazione. Definire il risultato atteso e cosa costituirebbe un errore significativo. L'assistenza per la scrittura interna ha conseguenze diverse da una risposta pubblica su prezzo, tempistica o termini contrattuali.
Le Framework di gestione del rischio AI NIST e il suo profilo generativo-AI offre riferimenti per l'organizzazione della valutazione. non approvano un particolare prodotto. I tuoi criteri dovrebbero collegare i rischi all'attività, al pubblico e all'uso del suo output.
- compito e pubblico.
- esito verificabile.
- errori accettabili e di blocco.
- Titolare della decisione.
Esamina i dati e il percorso di uscita
Elenca i dati inviati al servizio, le persone che possono accedervi, le regole di conservazione e i termini di utilizzo dichiarati. Verificarli nella documentazione e nel contratto del fornitore. Non dare per scontato che ogni prodotto di un'azienda abbia le stesse condizioni. Un account consumer, un piano API e Enterprise potrebbero differire.
Preparare esempi sintetici anonimi o chiaramente etichettati per le prove iniziali. Definire cosa può essere esportato, come cambiare i fornitori e quale attività rimane possibile durante un'interruzione. Memorizza le istruzioni, le fonti e le valutazioni in modo che il prossimo team di progetto possa capirle.
- Dati consentiti per il test.
- termini specifici per l'offerta.
- Accesso, conservazione ed esportazione.
- Fallback manuale.
Costruisci un piccolo ma impegnativo set di test
Raccogli casi rappresentativi e difficili: informazioni mancanti, fonti contrastanti, ambiguità, un'altra lingua e tentativi di deviare le istruzioni. Definire le risposte di riferimento o i criteri di accettazione prima del test. Uno strumento che rifiuta di rispondere quando mancano le informazioni può essere più utile di uno che produce un'invenzione convincente.
Misurare l'accuratezza, le omissioni, i riferimenti, la latenza e il costo separatamente nello scenario scelto. Esamina più output perché la generazione può variare. Conserva la versione del modello o dell'offerta quando noto, impostazioni utili, data di prova ed esempi. Un singolo punteggio totale non dovrebbe nascondere il fallimento su un compito essenziale.
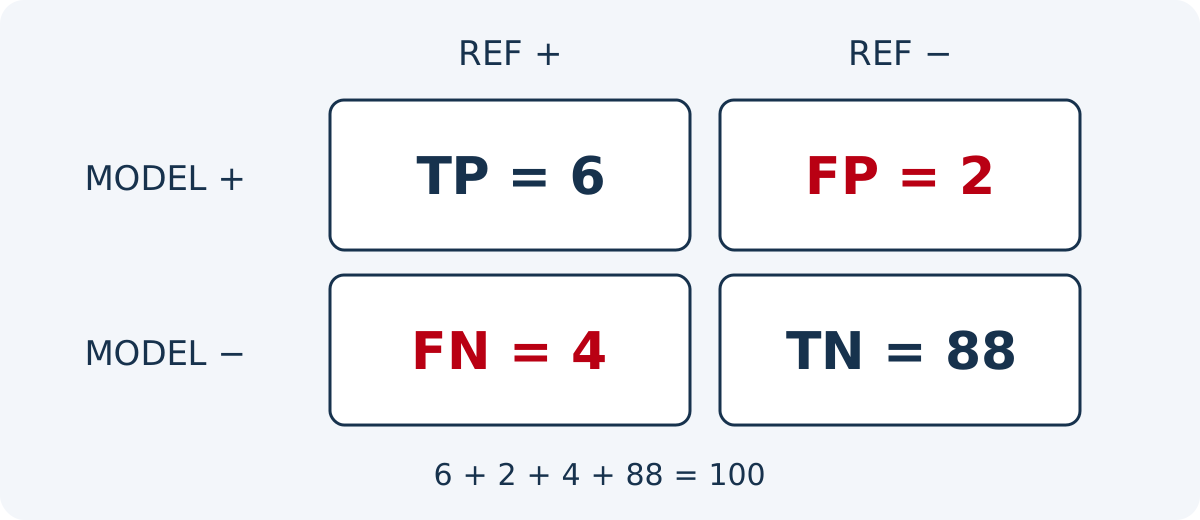
Esercizio fittizio di classificazione delle richieste, senza attribuire risultati a uno strumento: su 100 casi di riferimento, 10 richiedono revisione umana e 90 no. La regola ne segnala 8: 6 da rivedere (TP) e 2 falsi allarmi (FP). Perde 4 casi da rivedere (FN) ed esclude correttamente gli altri 88 (TN). L’accuratezza complessiva, accuracy, è (6 + 88) / 100 = 94 %. La precisione delle segnalazioni, precision, è però 6 / 8 = 75 % e il richiamo, recall, soltanto 6 / 10 = 60 %.
Le metriche rispondono a domande diverse: decisioni corrette, segnalazioni giustificate e casi obiettivo trovati. Il corso di classificazione Google spiega i denominatori; una accuracy elevata può nascondere casi rari persi. Fissate definizione del positivo, eventuale soglia e insieme di riferimento prima del confronto e conservate i quattro conteggi. Un denominatore zero rende la frazione indefinita: non trasformatelo arbitrariamente in successo. Queste metriche di classificazione non misurano da sole qualità fattuale di un testo generato o affidabilità generale.
- Casi rappresentativi e di bordo.
- criteri concordati prima del test.
- Errori documentati per esempio.
- Versione e data di prova.
Scorri la tabella orizzontalmente per leggere tutte le colonne. Con la tastiera, porta il focus sulla tabella e usa i tasti freccia.
| Metrica | Calcolo sull’insieme fittizio | Significato del denominatore |
|---|---|---|
| Accuratezza globale (accuracy) | (6 + 88) / 100 = 94 % | Tutte le classificazioni, corrette o errate |
| Precisione delle segnalazioni (precision) | 6 / (6 + 2) = 75 % | Gli otto casi segnalati |
| Richiamo (recall) | 6 / (6 + 4) = 60 % | I dieci casi che richiedevano revisione |
| Casi persi (FN) | FN = 4 | Quattro positivi reali non segnalati |
Limita la distribuzione e la rivalutazione nel tempo
Inizia con gli output esaminati. Per un assistente pubblico, limitare le possibili azioni, rendere disponibili le fonti e fornire un contatto umano quando una richiesta non rientra nel suo mandato. Test di recupero dopo interruzioni, risposte non valide e modifiche ai documenti. Osservare i risultati senza conservare inutilmente i dati personali.
Ripetere i test quando cambiano modelli, istruzioni, documentazione o capacità. Le Guida alla verifica della fonte Supporta la revisione editoriale. LeDirectory delle risorse AI offre punti di partenza ufficiali per confrontare i servizi senza garantire i loro risultati.
Documenti di riferimento
- Framework di gestione del rischio AI NIST · Fonte consultata
- Google ML : Accuracy, recall and precision · Fonte consultata
Contenuto aggiornato