
Temps de lecture estimé : 5 min · Publié le
Définir une tâche et son niveau d’exigence
Choisissez une tâche précise : suggérer des titres, classer des demandes, traduire une page ou répondre à partir d’une documentation. Définissez le résultat attendu et ce qui constituerait une erreur importante. Une aide à la rédaction interne n’a pas les mêmes conséquences qu’une réponse publique sur un prix, un délai ou une condition contractuelle.
Le cadre de gestion des risques de l’IA du NIST et son profil consacré à l’IA générative offrent des repères pour organiser l’évaluation. Ils ne valident pas un produit particulier. Votre grille doit relier les risques au contexte de la tâche, au public et à la manière dont le résultat sera utilisé.
- Tâche et public.
- Résultat vérifiable.
- Erreurs acceptables ou bloquantes.
- Responsable de la décision.
Examiner les données et la réversibilité
Listez les données envoyées au service, les personnes qui peuvent y accéder, les règles de conservation et les conditions d’usage annoncées. Vérifiez ces informations dans la documentation et le contrat du fournisseur. Ne partez pas du principe que tous les produits d’un même éditeur ont les mêmes règles. Un compte grand public, une API et une offre d’entreprise peuvent avoir des conditions distinctes.
Préparez d’abord des exemples anonymisés ou synthétiques clairement identifiés pour les essais. Définissez ce qui peut être exporté, comment changer de fournisseur et quelle tâche restera possible en cas d’indisponibilité. Le stockage des instructions, sources et évaluations doit rester compréhensible pour l’équipe qui reprendra le projet.
- Données autorisées pour le test.
- Conditions propres à l’offre utilisée.
- Accès, conservation et export.
- Solution de reprise manuelle.
Constituer un petit jeu de tests exigeant
Réunissez des exemples représentatifs et des cas difficiles : information absente, source contradictoire, demande ambiguë, langue différente et tentative de détourner les consignes. Définissez la réponse de référence ou les critères d’acceptation avant l’essai. Un outil qui refuse de répondre lorsqu’une donnée manque peut être plus utile qu’un outil qui produit une réponse convaincante mais inventée.
Mesurez séparément exactitude, omissions, références, temps de réponse et coût dans le scénario choisi. Relisez plusieurs résultats : une génération peut varier. Conservez la version du modèle ou de l’offre quand elle est connue, les paramètres utiles, la date du test et les exemples utilisés. Aucun score global ne doit masquer un échec sur une tâche essentielle.
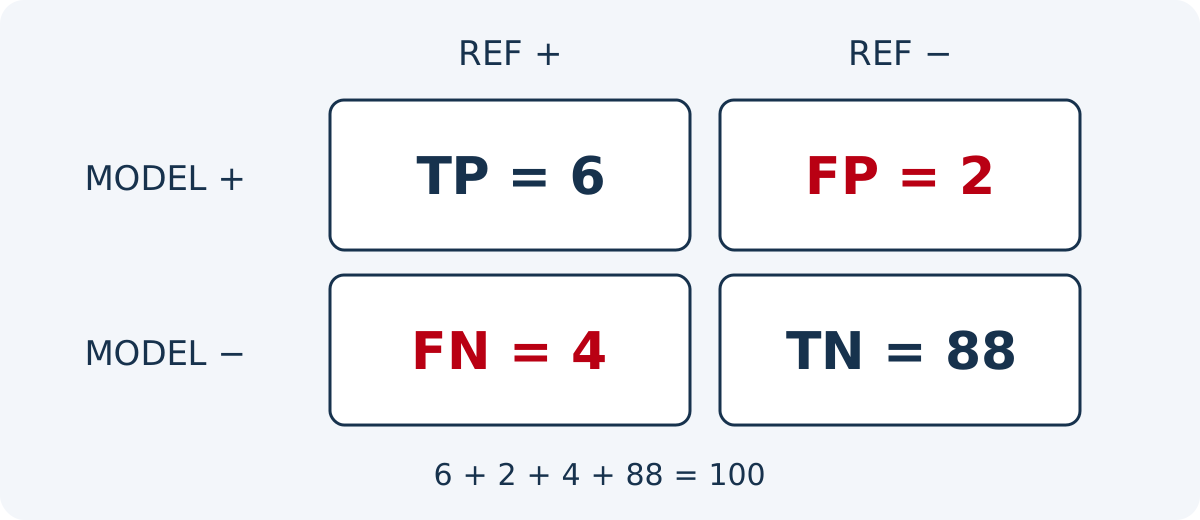
Exercice fictif de classement de demandes, sans résultat attribué à un outil : sur 100 cas de référence, 10 nécessitent une relecture humaine et 90 non. La règle étudiée en signale 8 : 6 sont bien à relire (TP) et 2 sont de fausses alertes (FP). Elle manque 4 cas à relire (FN) et écarte correctement les 88 autres (TN). Le taux de classifications correctes, accuracy, atteint (6 + 88) / 100 = 94 %. Pourtant, la précision des signalements, precision, vaut 6 / 8 = 75 %, et le rappel, recall, seulement 6 / 10 = 60 %.
Ces mesures répondent à des questions différentes : combien de décisions sont correctes, combien de signalements sont justifiés et combien de cas à détecter sont retrouvés. Le cours de classification de Google explicite leurs dénominateurs ; un score élevé d’accuracy peut masquer des cas rares manqués. Fixez la définition du cas positif, le seuil éventuel et le jeu de référence avant comparaison, puis conservez les quatre effectifs. Un dénominateur nul rend la fraction indéfinie : ne le transformez pas arbitrairement en réussite. Ces métriques de classification ne mesurent pas, à elles seules, la qualité factuelle d’une réponse rédigée ni une fiabilité générale.
- Cas représentatifs et cas limites.
- Critères définis avant le test.
- Erreurs documentées par exemple.
- Version et date des essais.
Faites défiler le tableau horizontalement pour lire toutes les colonnes. Au clavier, placez le focus sur le tableau puis utilisez les flèches.
| Mesure | Calcul sur le lot fictif | Ce que le dénominateur représente |
|---|---|---|
| Exactitude globale (accuracy) | (6 + 88) / 100 = 94 % | Toutes les classifications, correctes ou incorrectes |
| Précision des signalements (precision) | 6 / (6 + 2) = 75 % | Les huit cas signalés |
| Rappel (recall) | 6 / (6 + 4) = 60 % | Les dix cas qui nécessitaient une relecture |
| Cas à relire manqués (FN) | FN = 4 | Quatre cas réellement positifs non signalés |
Limiter le déploiement et vérifier dans la durée
Commencez par un usage où les résultats sont relus. Pour un assistant public, limitez les actions possibles, rendez les sources accessibles et prévoyez une orientation vers une personne quand la demande dépasse le périmètre. Testez la reprise après une panne, une réponse invalide ou une modification des documents. Les résultats doivent être observables sans enregistrer inutilement des données personnelles.
Refaites les tests après un changement de modèle, d’instructions, de documentation ou de fonctionnalités. Le guide de vérification des sources aide à relire les productions éditoriales. L’annuaire des ressources d’IA présente des points de départ officiels pour comparer les offres, sans garantir leurs résultats.
Documents de référence
- cadre de gestion des risques de l’IA du NIST · Source consultée
- Google ML : Accuracy, recall and precision · Source consultée
Complément de lecture
Pour élargir les options avant un essai, cette bibliothèque propose des parcours sur le choix d’un outil, les sources, les données confidentielles et les tests reproductibles. Utilisez-la pour préparer une liste de solutions à examiner, puis appliquez votre propre protocole aux tâches et contraintes du projet.
WORLD AI GUIDE : guides de choix et d’évaluation des outils IA
Contenu mis à jour le